Что такое парсинг сайтов
Парсинг сайтов — это автоматизированное извлечение выбранных данных из веб-источников с последующим преобразованием в заданную структуру. Парсер открывает страницы или получает ответы сервера, находит нужные поля и передаёт результат в таблицу, базу данных, CRM, 1С, BI-систему или другой сервис.
Например, сотрудник интернет-магазина может ежедневно проверять сайты поставщиков, копировать цены и отмечать наличие товаров. Парсер выполняет эту часть работы автоматически. Однако бизнесу обычно нужен не HTML-код страницы, а очищенные и сопоставимые сведения: конкретный товар, актуальная цена, регион, продавец, остаток и дата проверки.
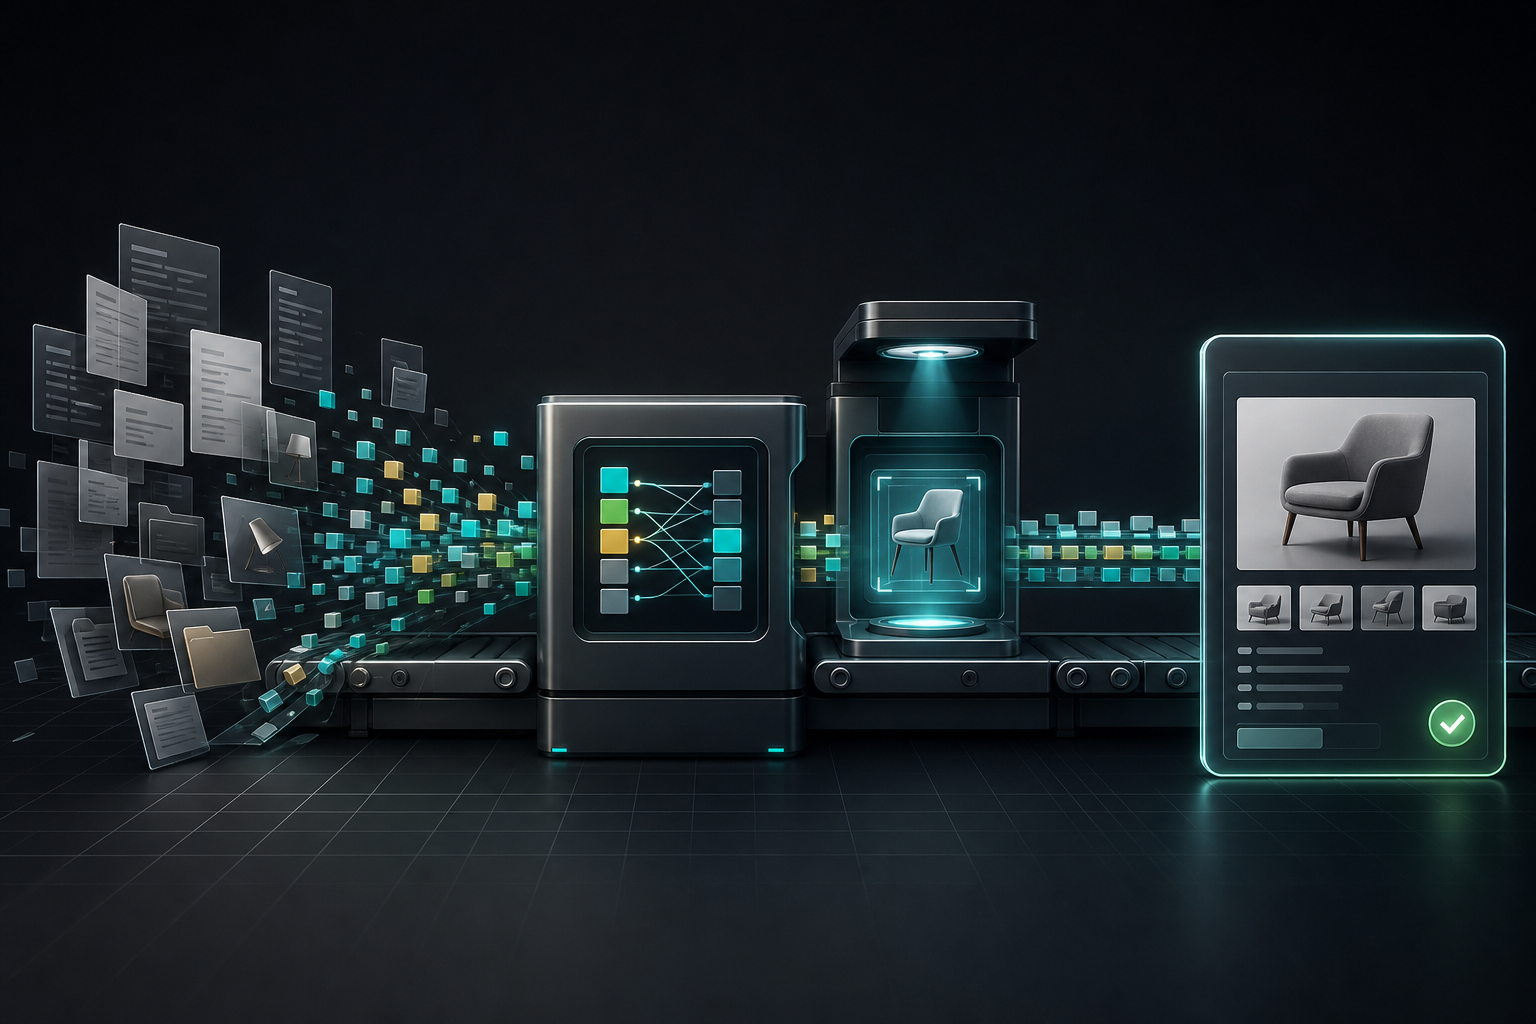
Поэтому рабочая система парсинга — это не только скрипт для загрузки страниц. Она включает извлечение, очистку, нормализацию, проверку, хранение, передачу данных и контроль регулярных запусков.
Парсинг может быть разовым, когда нужно один раз собрать информацию в Excel, или регулярным — с обновлением по расписанию, историей изменений и уведомлениями об ошибках.
| Способ получения данных | Когда подходит |
|---|---|
| Официальное API | Источник предоставляет нужные данные и разрешённый программный интерфейс |
| Фид, Excel, CSV или XML | Поставщик регулярно формирует готовую выгрузку |
| Парсинг | Данные доступны на страницах, а API или фид отсутствует либо не содержит нужных полей |
Если подходящее API или стабильная выгрузка уже существуют, обычно разумнее начать с них. Парсинг применяется для недостающих сведений или в случаях, когда другого интерфейса нет.
Какие данные можно собирать
Состав результата определяется бизнес-задачей. Технически из согласованных источников можно извлекать:
- названия товаров, категории, бренды, артикулы и SKU;
- цены, старые цены, скидки и условия акций;
- наличие, сроки и стоимость доставки;
- характеристики, варианты комплектации и единицы измерения;
- ссылки на карточки, изображения и документы;
- рейтинги, количество отзывов и заданные параметры отзывов;
- объявления, вакансии, новости и даты публикаций;
- изменения страниц и появление новых записей.
Результат можно сохранить в Excel, CSV, JSON или XML, записать в PostgreSQL и другую базу либо передать по API в рабочую систему.
Техническая возможность получить поле не означает, что его разрешено использовать без ограничений. Отдельной проверки требуют персональные данные, фотографии, тексты, составные базы и информация, доступная только после авторизации.
Какие задачи бизнеса решает парсинг
Наполнение и обновление каталогов
Парсер помогает перенести данные поставщика в интернет-магазин или внутреннюю товарную систему. Он может собирать новые позиции, характеристики, цены и наличие, а затем обновлять изменившиеся записи.
Прямого копирования обычно недостаточно. У разных источников отличаются названия категорий, обозначения брендов и форматы характеристик. Один поставщик указывает объём как «500 мл», другой — как «0,5 л». До загрузки на сайт значения необходимо привести к единому справочнику.
Система также может находить появившиеся и исчезнувшие позиции, фиксировать изменения и направлять спорные записи менеджеру. Это особенно полезно, когда каталог содержит тысячи товаров и регулярно обновляется.
Мониторинг цен и наличия
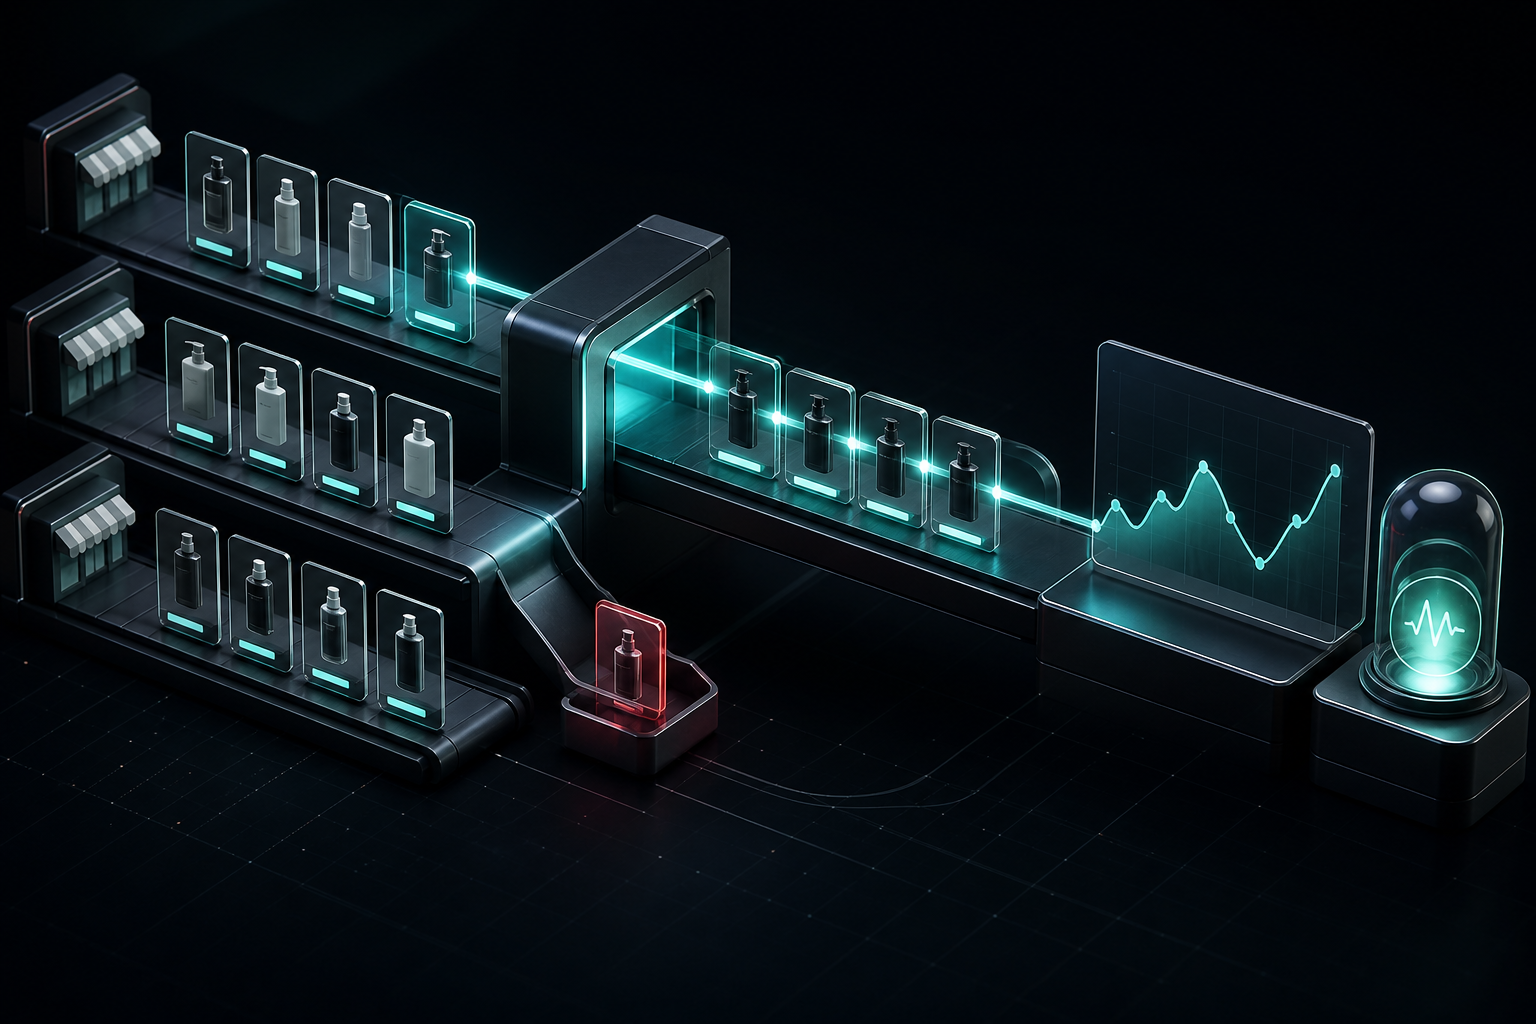
Для ценового анализа недостаточно извлечь одно число. Цена зависит от региона, продавца, наличия, акции, количества товара и способа доставки. Если эти параметры не учитывать, сравнение может быть формально корректным, но бесполезным для коммерческого решения.
Система мониторинга может сохранять текущую и старую цену, доступность, продавца, дату проверки и историю изменений. На этом основании бизнес формирует отчёты, получает уведомления о достижении заданного порога или передаёт данные в модуль репрайсинга.
При этом парсер не должен самостоятельно менять стоимость без согласованных правил. Он отвечает на вопрос «что изменилось», а бизнес-логика — «что с этим делать».
Анализ конкурентов и ассортимента
Регулярный сбор данных помогает отслеживать новые товары и бренды, изменение категорий, промоакции, наполнение карточек и динамику отзывов. Это даёт материал для решений по ассортименту, закупкам и позиционированию.
Интерпретировать показатели нужно осторожно. Например, остаток на витрине конкурента может быть косвенным сигналом, но не доказывает объём его продаж: отображаемое число зависит от склада, региона, резервов и правил площадки.
Сбор и агрегация контента
Парсинг применяют для агрегаторов новостей, объявлений, вакансий, технической документации и отраслевых публикаций. Система собирает метаданные, даты, рубрики и ссылки, удаляет дубли и формирует единую ленту.
Агрегацию ссылок и кратких сведений следует отделять от полного копирования чужих материалов. Перед публикацией текстов, фотографий или файлов нужно проверить права и условия использования. Для товарного каталога безопаснее использовать собранные факты как исходные данные, а собственные описания и медиаматериалы готовить отдельно.
Как работает система парсинга
Путь от страницы до рабочего отчёта обычно включает семь этапов:
- Постановка задачи. Фиксируются источники, поля, объём, периодичность и формат результата.
- Проверка способов доступа. Команда изучает официальные API, фиды, правила площадки и технические ограничения.
- Обход источников. Парсер получает список страниц и загружает их с согласованной частотой.
- Извлечение. Из страницы или ответа выделяются название, цена, артикул и другие заданные поля.
- Очистка и нормализация. Удаляется служебный текст, приводятся к единому виду валюты, даты, бренды и единицы измерения.
- Сопоставление и проверка. Дубли объединяются, товары связываются с внутренним каталогом, а сомнительные значения отправляются на проверку.
- Хранение и передача. Результат записывается в базу, выгружается в файл или поступает в сайт, CRM, 1С либо BI.
Структурирование и сопоставление
Матчинг — сопоставление одинаковых объектов из разных источников — нередко сложнее самого сбора. Один товар может называться «X Pro 2», «X Pro II, чёрный» или обозначаться кодом «XP2-BLK». Отдельно может продаваться комплект из двух единиц.
В качестве сигналов для сопоставления обычно используют SKU, артикул производителя, EAN/GTIN, бренд и модель, но их надёжность зависит от источника: SKU часто является внутренним кодом продавца, а EAN может относиться к варианту или упаковке. Если однозначных идентификаторов нет, система использует сочетание названия и характеристик, а неоднозначные пары подтверждает сотрудник. Иначе цена одного варианта может быть ошибочно присвоена другому.
Также обрабатываются значения вроде «от 12 990 ₽», разные валюты, отсутствующие поля и несколько вариантов товара в одной карточке. Правила преобразования фиксируются заранее, чтобы одинаковые данные всегда обрабатывались одинаково.
Обновления и контроль ошибок
Частоту выбирают по скорости изменения источника и стоимости устаревших данных. Цены и наличие могут проверяться несколько раз в день, а стабильный справочник — раз в неделю или реже. Чем чаще запуски, тем выше нагрузка на источник и инфраструктуру, поэтому обновление «каждую минуту» без бизнес-причины не является преимуществом.
Для регулярной работы предусматриваются повторные попытки после временных ошибок, журнал запусков, уведомления о сбоях и дата последнего успешного обновления. История значений позволяет увидеть динамику и восстановить состояние на нужный момент.
Антибот-защита и изменения сайта
Сложность источника зависит не только от количества страниц. Данные могут загружаться через JavaScript, появляться после выбора региона или храниться в нескольких запросах. На результат способны влиять сессия, авторизация и выбранный склад.
Площадки также ограничивают частоту обращений, используют CAPTCHA и меняют структуру страниц. Если разработчик привязал извлечение к одному элементу вёрстки, после редизайна нужное поле может исчезнуть или переместиться.
Устойчивое решение не должно работать «любой ценой». Оно соблюдает согласованный режим доступа, ограничивает нагрузку, обрабатывает временные ошибки и останавливает некорректную выгрузку. При изменении источника система должна обнаружить падение числа записей, пропажу обязательных полей или необычный рост ошибок и отправить уведомление.
Иногда после анализа выгоднее перейти на API, фид поставщика или другой источник. Поэтому регулярный мониторинг требует поддержки и адаптации, а не заканчивается передачей исходного скрипта.
Юридические ограничения
В российском законодательстве нет универсального правила, по которому любой парсинг автоматически законен или незаконен. Оценка зависит от источника, способа доступа, состава данных, объёма извлечения и дальнейшего использования.
До разработки следует проверить:
- доступна ли информация без обхода авторизации и технических ограничений;
- содержит ли набор персональные данные;
- не извлекается ли существенная часть охраняемой базы данных;
- копируются ли тексты, фотографии и другие объекты авторских прав;
- что устанавливают правила использования и договорные условия площадки;
- как сведения будут храниться, объединяться, публиковаться и передаваться.
Общедоступность информации сама по себе не исключает необходимости проверить другие ограничения, связанные с правами на контент, базу данных и персональные данные. В частности, структура и существенная часть базы могут охраняться главой 71 ГК РФ «Право на результат интеллектуальной деятельности в составе базы данных», а обработка персональных данных регулируется статьёй 6 Федерального закона № 152-ФЗ, где перечислены основания для обработки. Открыто опубликованные сведения о человеке нельзя автоматически считать разрешёнными для любого повторного использования.
Файл robots.txt содержит предлагаемые роботам правила обхода, но не является механизмом авторизации и сам по себе не определяет законность проекта. Его нужно учитывать вместе с правилами площадки, способом доступа и характером данных.
Для первичной проверки полезны тексты 149-ФЗ об информации, 152-ФЗ о персональных данных, глава 71 ГК РФ о праве на базу данных и глава 70 ГК РФ об авторском праве. Для спорного проекта нужна консультация юриста с учётом конкретных источников и сценария использования.
Как контролировать качество данных
Парсер может технически завершить запуск, но вернуть неполный или неверно интерпретированный результат. Поэтому качество проверяют отдельно от факта выполнения задания.
Практический контроль включает следующие условия:
- обязательные поля заполнены;
- цены приведены к единой валюте и числовому формату;
- дубли найдены и обработаны;
- товары сопоставлены с внутренними идентификаторами;
- аномальные значения помещены в карантин или отправлены сотруднику;
- для каждой записи известны источник и дата обновления;
- при резком падении объёма выгрузки приходит уведомление;
- часть записей регулярно сравнивается с исходными страницами.
Полезно сохранять исходный ответ или его необходимые фрагменты. Тогда после изменения правил нормализации данные можно обработать повторно без нового обращения к источнику. Для критичных процессов также задают допустимую долю ошибок и срок реакции на сбой.
Когда бизнесу нужен собственный парсер
Индивидуальная разработка системы парсинга данных оправдана, если сотрудники регулярно копируют однотипную информацию, источников становится много, а устаревшие цены или остатки приводят к потерям. Собственное решение также нужно, когда результат должен автоматически поступать в интернет-магазин, CRM, 1С, базу или аналитическую панель.
Постоянная система полезна, если нужны история изменений, уведомления, сложное сопоставление товаров и правила обработки исключений. Готовый сервис может не поддерживать необходимые источники, авторизацию или внутренние справочники компании.
Парсер не обязательно разрабатывать, если задача небольшая и разовая, поставщик уже отдаёт качественный фид, данные почти не меняются либо в компании нет процесса, который будет использовать результат. Проект также стоит пересмотреть, когда технические и правовые риски выше ожидаемой пользы.
Для предварительной оценки достаточно подготовить ссылки на источники, 5–10 нужных полей, пример итоговой таблицы, примерный объём, частоту обновления и название системы, куда должны поступать данные. Эти вводные позволяют определить, нужна ли разовая выгрузка, регулярный парсинг или полноценная интеграция.
Как WebSolux применяет парсинг в проектах
Для интернет-магазина автозапчастей GONKA Shop команда WebSolux разработала e-commerce-платформу с каталогом более 15 000 товарных позиций и более чем 100 брендами и производителями. Парсеры внешних источников используются для получения и автоматического обновления цен и части каталожных данных. Это переносит регулярные операции по актуализации ассортимента из ручного процесса в систему.
Другой пример — CRM-платформа для автоматизации данных Wildberries. В ней объединены API и авторизованный web-scraping для регулярного получения информации из кабинетов продавцов. Фоновые задания собирают данные, система нормализует их и сохраняет в PostgreSQL, а очереди, повторные попытки, ограничения частоты, логи и мониторинг помогают контролировать каждый источник.
Оба проекта показывают разницу между отдельным скриптом и рабочим продуктом. Практическую ценность создаёт не количество загруженных страниц, а стабильная передача проверенных данных в каталог, CRM или другой бизнес-процесс.
Частые вопросы
Что можно парсить?
Парсер может извлекать доступные на странице товары, цены, характеристики, наличие, категории, рейтинги, отзывы, объявления, публикации и другие заданные поля. Возможность дальнейшего использования оценивается отдельно с учётом состава данных, прав на контент и базу, правил источника и законодательства.
Как часто нужно обновлять данные?
Частота зависит от скорости изменений и последствий задержки. Цены и наличие иногда проверяют несколько раз в день, стабильные справочники — значительно реже. Избыточно частые запросы увеличивают нагрузку, стоимость и риск ограничений, не создавая дополнительной пользы.
Что делать, если сайт изменился?
Система должна обнаружить аномалию: падение числа записей, исчезновение обязательных полей или рост ошибок. Затем разработчик обновляет правила извлечения либо переводит источник на API, фид или другой доступный способ. Поэтому регулярному парсингу нужны мониторинг и поддержка.
Законен ли парсинг сайтов?
Универсального ответа нет. Публичный доступ к странице не снимает ограничений, связанных с персональными данными, правами на базу и контент, условиями использования сайта и способом доступа. Риск оценивают для конкретного источника и сценария; в спорных случаях требуется юридическая консультация.
Чем парсинг отличается от API?
API — официальный интерфейс, через который владелец системы предоставляет определённые данные. Парсинг извлекает сведения из страниц или ответов, предназначенных прежде всего для отображения пользователю. Если официальное API полностью закрывает задачу, обычно выбирают его.
Можно ли один раз разработать парсер и больше его не менять?
Иногда простой источник остаётся стабильным годами, но гарантировать это нельзя. Могут измениться вёрстка, адреса, авторизация и способ загрузки информации. Для критичных процессов заранее предусматривают мониторинг, документацию и регламент поддержки.
Главное
Парсинг сайтов полезен, когда превращает разрозненную информацию в управляемый поток данных. Для бизнеса это означает не просто выгрузку в Excel, а очистку, сопоставление, контроль качества, историю обновлений и интеграцию с системой, в которой сотрудники принимают решения.
Обсудить парсер: пришлите WebSolux ссылки на источники, перечень полей и желаемый формат результата. Мы оценим доступные способы получения данных и предложим подходящий формат — от разовой выгрузки до регулярной системы с интеграцией.