Какие задачи решает мониторинг цен конкурентов
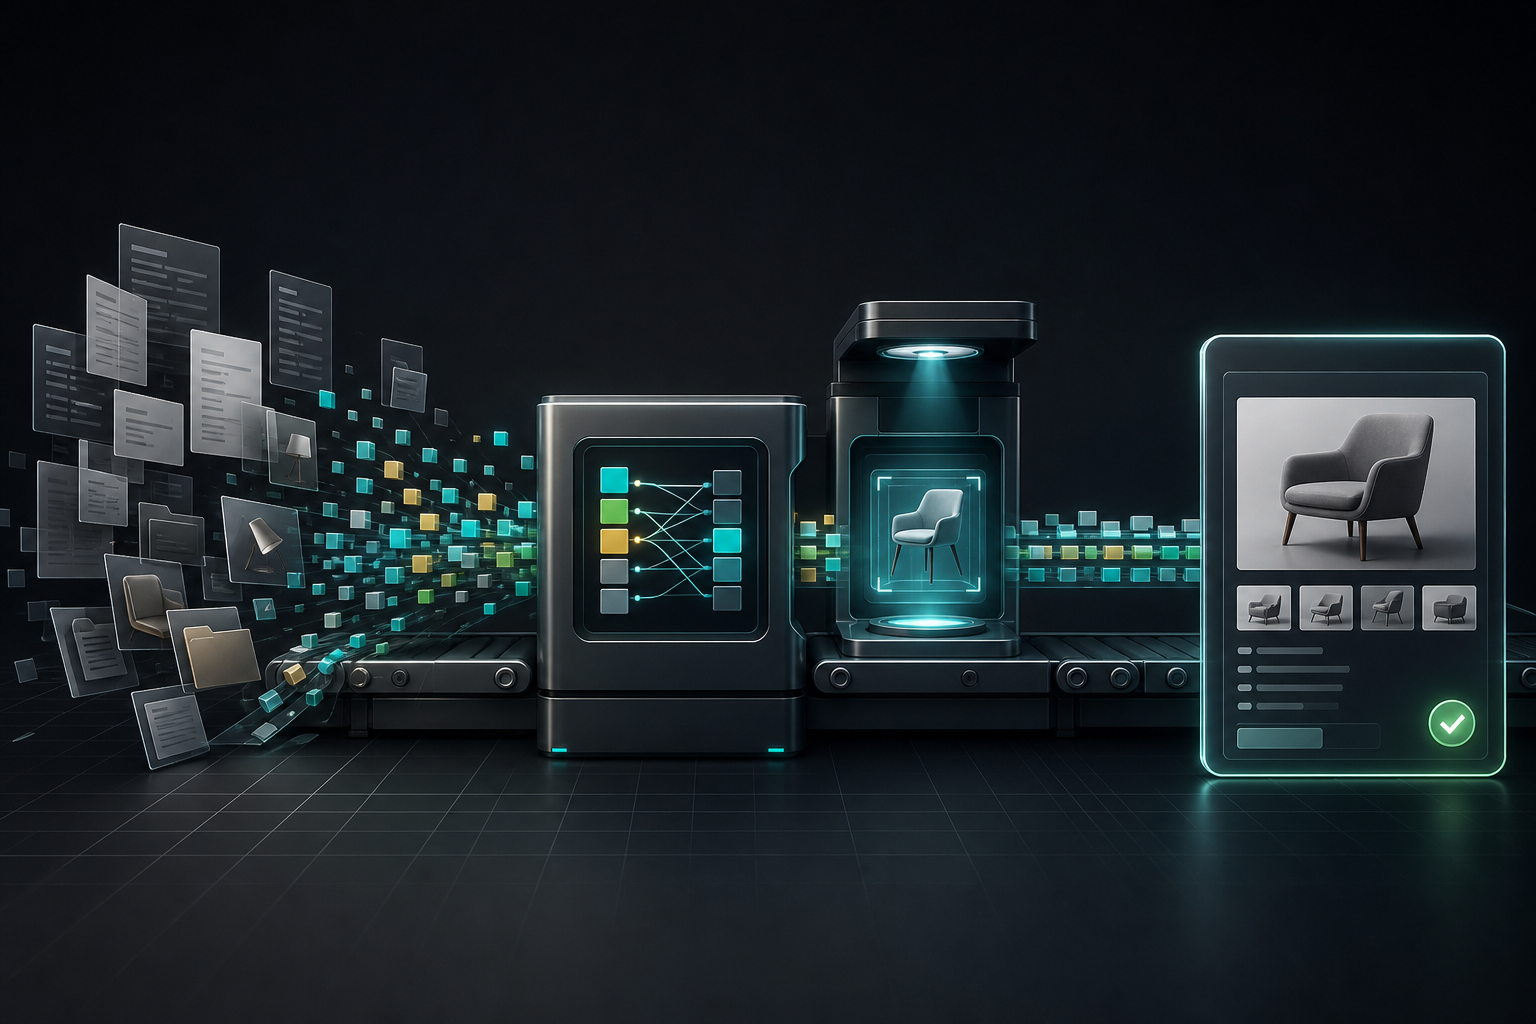
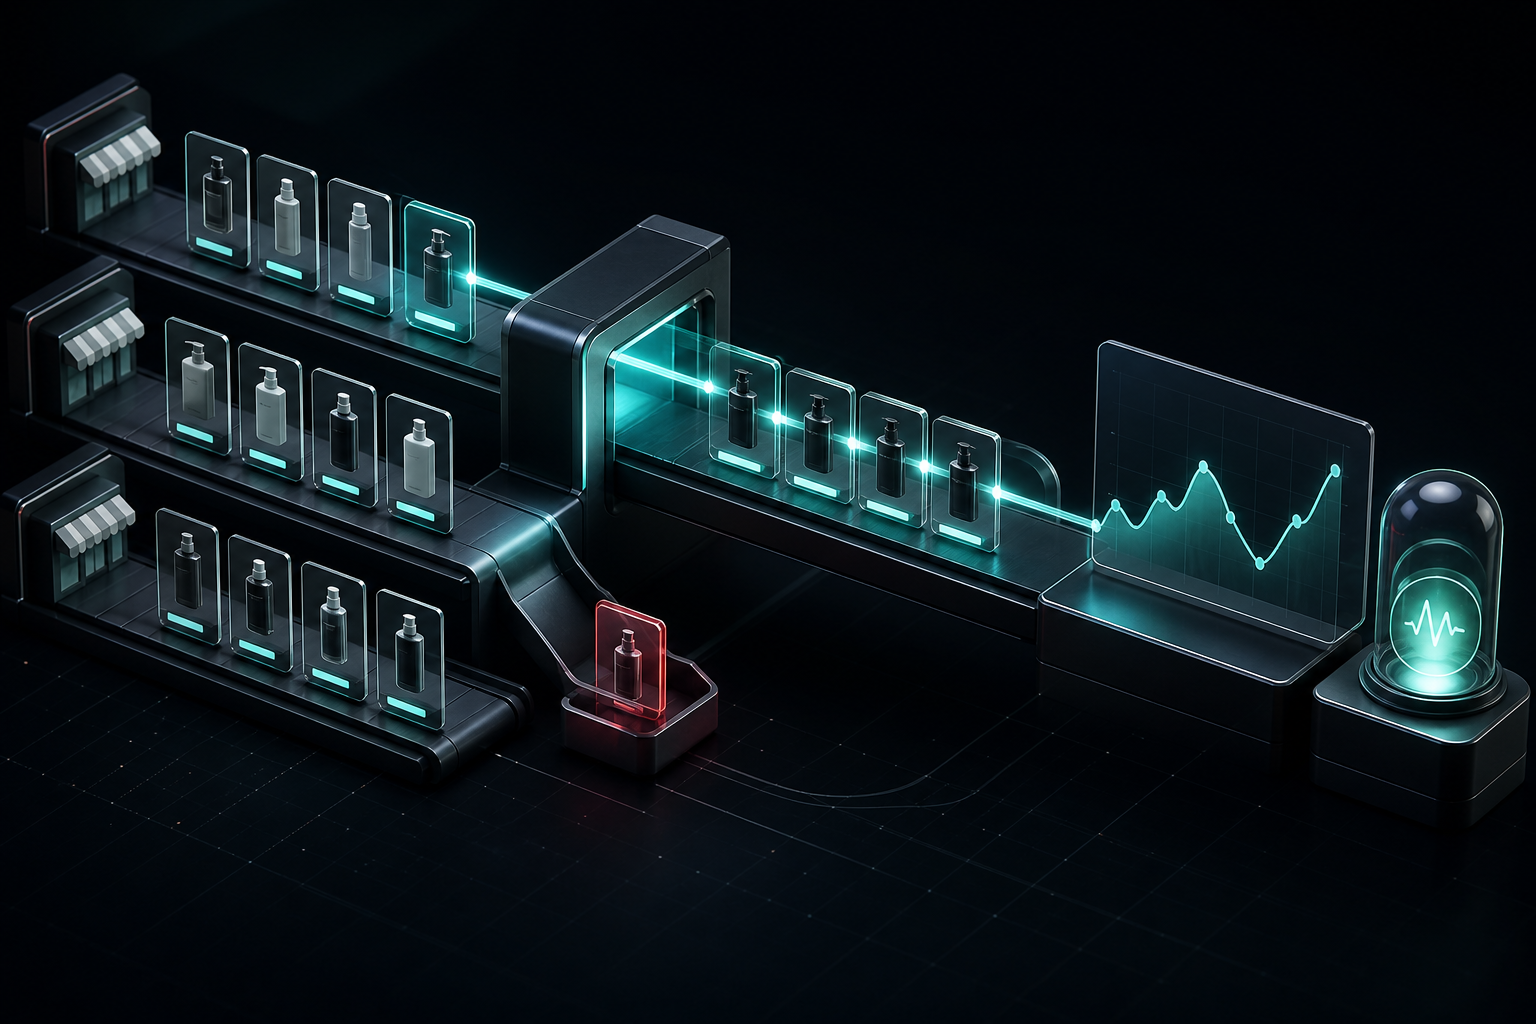
Автоматический мониторинг цен конкурентов регулярно получает данные из внешних источников, связывает предложения с внутренним каталогом, проверяет результат и сообщает о значимых изменениях. Парсер отвечает только за сбор. Для принятия решений также нужны сопоставление товаров, история цен, контроль качества, отчёты и уведомления.
До разработки важно определить результат, который требуется бизнесу. Это может быть сравнительный отчёт для категорийного менеджера, сигнал о появлении более дешёвого предложения, контроль акций и наличия или передача проверенных данных в систему ценообразования.
Мониторинг может решать несколько задач:
- показывать минимальную, медианную и максимальную цену по товару;
- фиксировать акции, изменение наличия и появление новых продавцов;
- находить позиции, по которым компания стала заметно дороже или дешевле рынка;
- сохранять историю для анализа динамики;
- формировать отчёты по категориям, брендам и конкурентам;
- передавать данные в таблицу, CRM, 1С, BI или внутренний сервис;
- готовить рекомендации по переоценке с учётом себестоимости и минимальной маржи.
Ориентироваться только на самую низкую найденную цену рискованно. Предложение может относиться к другой комплектации, отсутствовать на складе, действовать только по карте лояльности или не учитывать доставку. Поэтому ещё до запуска фиксируют, какую цену и при каких условиях следует сравнивать.
Откуда получать цены
API, фиды и страницы сайтов
Сначала стоит использовать наиболее стабильный и структурированный способ получения данных. Приоритет обычно выглядит так:
- официальный API, если у компании есть право доступа;
- товарный фид в XML, CSV или другом согласованном формате;
- структурированные данные страницы, например JSON-LD с сущностями Product и Offer;
- сетевые ответы, через которые интерфейс получает товарные данные;
- HTML и DOM страницы;
- браузерный сценарий для контента, который появляется после выполнения JavaScript или действий пользователя.
API и фид обычно устойчивее HTML-парсинга, но доступны не всегда. Структурированные данные также удобны, однако их нужно проверять: отображаемая посетителю цена и значение в разметке могут обновляться не одновременно. Для динамических страниц иногда требуется браузер без графического интерфейса или анализ запросов, выполняемых самим сайтом.
Что собирать кроме цены
Одного поля price недостаточно. На карточке могут одновременно присутствовать обычная, зачёркнутая, акционная и клубная цены. Значение также может зависеть от региона, выбранного варианта, продавца или способа доставки.
| Группа | Какие данные фиксировать |
|---|---|
| Товар | Название, бренд, модель, артикул, GTIN, характеристики и вариант |
| Предложение | Обычная и акционная цена, валюта, продавец, наличие |
| Контекст | Регион, доставка, программа лояльности, количество в упаковке |
| Контроль | URL, время проверки, статус сбора, уверенность сопоставления |
Контекст определяет, можно ли сравнивать предложения. Например, товар за 9 900 рублей с платной доставкой не обязательно выгоднее предложения за 10 100 рублей с бесплатной доставкой. Если важна итоговая стоимость покупки, доставку учитывают отдельным правилом.
Как устроен парсер цен
Рабочий контур состоит из нескольких компонентов:
- Планировщик создаёт задания по расписанию и учитывает приоритеты товаров.
- Сборщики получают ответы API, фиды или страницы.
- Экстрактор находит цену, наличие, продавца и идентификаторы.
- Нормализатор приводит числа, валюты, единицы и статусы к единому формату.
- Модуль сопоставления связывает внешнее предложение с позицией внутреннего каталога.
- Валидатор проверяет полноту, диапазоны и аномальные изменения.
- Хранилище записывает текущее состояние и историю наблюдений.
- Правила рассчитывают отклонения и запускают уведомления.
Для реализации могут использоваться Scrapy или HTTP-клиенты, Playwright для браузерных сценариев, очередь фоновых задач, Redis и PostgreSQL. Конкретный стек вторичен: устойчивость в большей степени зависит от разделения компонентов, журналирования и возможности локализовать ошибку одного источника.
WebSolux разрабатывает решения для сбора данных, мониторинга цен, агрегации и автоматических отчётов. В портфолио представлен сервис, который автоматически собирает данные из кабинетов продавцов Wildberries, нормализует их и сохраняет в собственной CRM-платформе. В проекте использовались Celery, Redis, Playwright и HTTPX. Этот кейс не относится к мониторингу конкурентов, но показывает пример контура сбора и обработки данных. Подробнее о направлениях работы можно узнать в разделе услуг WebSolux, а о реализованных проектах — в портфолио.
Самая сложная часть — сопоставление SKU
Найти число на странице обычно проще, чем доказать, что оно относится к нужному товару. Неверно сопоставленный SKU опаснее пропущенной цены: система продолжает работать без явной ошибки, но сравнивает разные позиции и может передать ложный сигнал менеджеру или модулю переоценки.
Точные идентификаторы
Для идентичных товаров кандидаты проверяются в следующем порядке:
- GTIN, EAN или UPC;
- артикул производителя — MPN;
- бренд и точная модель;
- набор обязательных характеристик категории.
Даже совпадение GTIN не всегда означает полную сопоставимость коммерческих предложений. Могут различаться состояние товара, продавец, гарантия, регион поставки или условия доставки. Поэтому сопоставление товаров и сравнение предложений лучше разделять: сначала определяется товар, затем проверяются условия конкретного предложения.
Варианты, комплекты и упаковки
Название и изображение не доказывают идентичность. Смартфоны одной модели на 128 и 256 ГБ выглядят одинаково, но являются разными вариантами. Одна бутылка и упаковка из трёх могут иметь почти одинаковое название. Новое и восстановленное устройство иногда размещаются в одной товарной семье.
Для каждой категории нужен набор признаков, без совпадения которых автоматическая связка запрещена. Для электроники это могут быть модель, память, цвет и состояние. Для расходных материалов — объём, количество единиц и совместимость. Для одежды — размер, цвет и вариант модели.
Оценка уверенности и ручная проверка
Если точного идентификатора нет, система формирует кандидатов по бренду, нормализованному названию и характеристикам. Каждая пара получает оценку уверенности:
- точное совпадение — допускается в отчёты и автоматические правила;
- вероятное совпадение — поступает человеку на проверку;
- слабое совпадение — не используется для сравнения цен.
AI может помогать сравнивать названия, описания и изображения, но не заменяет бизнес-правила и ручную проверку спорных пар. Подтверждённые связи также нужно периодически пересматривать: карточка конкурента может изменить комплектацию, название или начать вести на новую модель.
Технический показатель успешно открытых страниц не равен качеству мониторинга. Система может загрузить почти все URL, но извлечь цену неправильного варианта или связать её не с тем SKU.
Как выбрать частоту и хранить историю цен
Проверять цены стоит достаточно часто, чтобы не пропускать значимые изменения, но не чаще, чем бизнес способен на них реагировать. Универсального расписания для всего каталога нет.
Практичная сегментация выглядит так:
- ключевые SKU, бестселлеры и промопозиции — несколько раз в день;
- основной ассортимент — ежедневно;
- длинный хвост — через несколько дней или по отдельному расписанию;
- дополнительные запуски — перед акциями и в периоды высокого спроса.
Объём нагрузки можно предварительно оценить по формуле:
Проверок в сутки = SKU × источники на SKU × запусков в сутки
Например, для 5 000 товаров, четырёх конкурентов и двух запусков потребуется 40 000 проверок в сутки. Это условный расчёт объёма операций, а не ориентир по производительности или стоимости проекта. Дополнительно могут потребоваться повторные запросы, поиск новых карточек и контрольные проверки.
История должна хранить не только цену, но и наличие, продавца, тип цены, регион, URL, время и статус проверки. Тогда можно отличить краткосрочную акцию от устойчивого изменения и восстановить хронологию при спорном результате.
Текущее состояние и историю удобно хранить отдельно. Первое нужно для оперативной панели, второе — для аналитики и аудита. Срок хранения выбирают с учётом сезонности и задач бизнеса.
Ошибки, изменения сайтов и ограничения доступа
После запуска источники неизбежно меняются. Карточка может переехать, цена — начать загружаться через JavaScript, а сервер — вернуть заглушку, капчу или ошибку ограничения частоты.
Вместо одинакового значения null для всех непонятных случаев полезно различать состояния:
| Статус | Что означает |
|---|---|
| in_stock | Товар найден и доступен |
| out_of_stock | Карточка работает, но товара нет в наличии |
| not_found | Карточка удалена или URL больше не существует |
| access_blocked | Источник ограничил доступ |
| parse_error | Страница получена, но ожидаемые поля не извлечены |
| needs_review | Результат или сопоставление требуют проверки |
| stale_data | Показывается последнее подтверждённое, но устаревшее значение |
При временном сбое запрос можно повторить с увеличивающейся задержкой. Для ответа HTTP 429 следует учитывать заголовок Retry-After, если сервер его передал. При отсутствии заголовка применяется собственная политика задержек и лимитов. Параллельность лучше ограничивать отдельно для каждого домена.
Резкое падение доли обработанных карточек, многократное изменение цены или исчезновение всех товаров должны вызывать техническое уведомление. Для диагностики полезно сохранять сырой ответ, ключевые фрагменты данных или снимок страницы. Последнюю подтверждённую цену можно оставить в интерфейсе только вместе с датой получения и отметкой об устаревании.
Корректный подход к ограничениям источника — щадящий сбор с контролем частоты, использованием доступных API и фидов, обработкой лимитов и учётом правил площадки. robots.txt описывает правила для автоматических клиентов, но не является механизмом авторизации и не определяет правомерность конкретного сценария сбора.
Правовую оценку мониторинга нельзя давать в отрыве от конкретного проекта. Она зависит от условий использования источника, режима доступа, объёма извлечения, прав на базу данных и способа применения результата. Отдельной оценки требуют обход авторизации или технических ограничений, а также сценарии автоматического ценообразования и контроля рекомендованных цен. Перед запуском такие вопросы стоит проверить с профильным юристом.
Уведомления и аналитическая панель
Какие уведомления полезны
Сообщение при каждом изменении на один рубль быстро превращается в информационный шум. Уведомления лучше привязывать к бизнес-событиям:
- конкурент стал дешевле на заданный процент или сумму;
- цена пересекла внутренний порог;
- товар появился или вернулся в наличие;
- ключевой источник давно не обновлялся;
- обнаружена аномальная цена;
- изменение относится к товару с высокой уверенностью сопоставления.
В сообщении нужны название товара, старая и новая цена, разница, наличие, конкурент, время проверки, ссылка и уверенность сопоставления. События можно направлять в Telegram, email, CRM или систему постановки задач.
Что показывать на панели
Руководителю и категорийной команде обычно нужны собственная цена, рыночный диапазон, медиана, позиция относительно конкурентов, динамика за период, наличие, свежесть данных и статус сопоставления. Медиана часто полезнее среднего: одно ошибочное или экстремальное предложение меньше искажает картину.
Отдельный блок стоит выделить под качество данных: долю актуальных наблюдений, источники с ошибками, число спорных пар и устаревших значений. Иначе аккуратные графики могут скрывать неполные данные.
Автоматическую переоценку лучше подключать после периода ручных рекомендаций. Правила должны учитывать себестоимость, минимальную маржу, максимальный шаг изменения и частоту переоценки.
Масштабирование на большой каталог
Для работы с тысячами товаров задания помещают в очередь, источникам назначают отдельные лимиты, а ассортимент делят по приоритету. Ключевые SKU проверяются чаще, длинный хвост — реже. Текущее состояние обновляется инкрементально, без полной пересборки всей базы.
Сложность определяет не только размер каталога. На неё влияют число источников, частота проверок, динамичность страниц, регионы, количество вариантов, качество исходных идентификаторов и глубина истории.
Пример WebSolux. В интернет-магазине автозапчастей GONKA Shop реализована работа с каталогом на 15 000+ позиций, парсерами, внешними интеграциями и автоматизацией обновления данных. Описание проекта доступно в общем разделе портфолио WebSolux.
Этапы внедрения мониторинга
- Зафиксировать бизнес-задачу. Определить, какие решения будут приниматься по данным, кто отвечает за реакцию и нужен ли в перспективе автоматический пересмотр цен.
- Описать источники. Согласовать конкурентов, регионы, продавцов, типы цен, наличие и доставку.
- Подготовить собственный каталог. Очистить бренды, модели, артикулы, GTIN и значимые характеристики.
- Провести пилот. Выбрать товары из нескольких категорий и два-три источника. Включить варианты, упаковки, акции и отсутствующие позиции.
- Создать эталонную выборку. Вручную проверить цены и товарные пары, затем сравнить их с результатом системы.
- Согласовать критерии приёмки. Зафиксировать полноту, свежесть, корректность цен и сопоставления, допустимую задержку, статусы ошибок и формат выгрузки.
- Подключить отчёты и уведомления. Сначала использовать рекомендации и ручное решение, чтобы проверить правила на реальных данных.
- Масштабировать. Добавить ассортимент, источники, регионы и более частое расписание.
- Назначить владельца системы. Он будет проверять спорные пары, согласовывать новые правила и получать технические уведомления.
На пилоте полезно измерять не абстрактную «точность парсера», а отдельные показатели: долю успешно обработанных URL, полноту цен, корректность товарных пар, свежесть данных и число наблюдений, отправленных на ручную проверку. Другие материалы об автоматизации доступны в блоге WebSolux.
Автоматизация мониторинга цен
Ценность мониторинга появляется не в момент, когда скрипт извлёк число, а когда бизнес получил проверенное изменение, по которому можно принять решение. Для этого важно учитывать контекст цены, правильно сопоставлять товары, замечать ошибки и сохранять историю.
WebSolux может спроектировать и разработать решение для сбора, мониторинга, обработки и передачи данных под конкретные процессы бизнеса. Обсудить задачу можно через раздел услуг WebSolux.
Источники и методология
Техническая часть материала опирается на документацию Google по структурированным данным для товарных предложений, RFC 6585 с описанием ответа HTTP 429 и RFC 9309 о протоколе robots.txt. При описании одного из возможных правовых рисков учитывалась статья 1334 ГК РФ о праве изготовителя базы данных. Эти документы не подтверждают правомерность любого мониторинга: условия конкретного проекта требуют отдельной технической и юридической оценки.