Подключить нейросеть — не значит вставить готовый чат
Надёжная интеграция ИИ обычно строится через серверный контур: пользовательский интерфейс отправляет запрос на backend, сервер проверяет права и лимиты, подбирает контекст, вызывает API модели и контролирует результат. Если нейросеть должна работать с CRM, каталогом или документами, эти системы также подключаются через backend.
Постоянный ключ AI-провайдера нельзя передавать в браузер или мобильное приложение: это раскрывает секрет, мешает контролировать расходы и повышает риск злоупотреблений. Для отдельных сценариев провайдер может официально поддерживать короткоживущие клиентские секреты, которые выдаёт сервер. Основной ключ и контроль доступа при этом остаются на backend.
Если компания только выбирает первый сценарий, сначала стоит определить процесс, ожидаемый результат и критерии качества. Этому посвящён материал «Как внедрить ИИ в бизнес: с чего начать» в блоге WebSolux. Ниже сосредоточимся на технической стороне: архитектуре, данных, функциях, стоимости и безопасности.
Что означает интеграция ИИ с сайтом или системой
Фраза «подключить нейросеть» может описывать решения разной сложности. Готовый виджет добавляется сторонним скриптом и подходит для быстрого теста, но ограничивает контроль над интерфейсом, данными и логикой. Собственная API-интеграция позволяет встроить ИИ в существующий сайт, личный кабинет, CRM или внутренний сервис.
У такой интеграции обычно три уровня:
| Уровень | Пример | Что требуется |
|---|---|---|
| Вызов модели | Создать описание товара или классифицировать заявку | Backend и API провайдера |
| Работа со знаниями | Ответить по регламентам и документам компании | RAG, индекс, источники и права доступа |
| Выполнение действий | Проверить заказ или создать лид в CRM | API систем, разрешённые функции и серверная валидация |
Чем ближе нейросеть к реальным данным и операциям, тем важнее права, аудит и бизнес-правила. Модель может подготовить ответ или предложить действие, но не должна самостоятельно решать, к каким данным пользователь имеет доступ и разрешено ли менять статус заказа.
Типовая архитектура интеграции
Пользователь или сотрудник
        ↓
Сайт, бот или внутренний интерфейс
        ↓
Backend компании
        ├─ авторизация и права
        ├─ rate limits и бюджеты
        ├─ история и подготовка контекста
        ├─ поиск по базе знаний
        ├─ вызов AI API
        ├─ проверка результата
        └─ логирование
        ↓
AI-провайдер
        ↓
Ответ или запрос на функцию
        ↓
CRM / 1С / каталог / БД / внутреннее API
Интерфейсом может быть форма на сайте, чат, кабинет сотрудника, Telegram-бот или модуль внутри CRM. Он отвечает за ввод данных и отображение результата, но не должен получать постоянный ключ AI-провайдера.
Основной API-ключ следует хранить на backend: в переменных окружения или менеджере секретов. Его нельзя добавлять во frontend-код, публичный репозиторий, мобильное приложение или отдавать браузеру через конфигурационный endpoint. Если провайдер поддерживает короткоживущие server-issued credentials для прямого клиентского соединения, их нужно выпускать на сервере с ограниченным сроком действия и областью доступа.
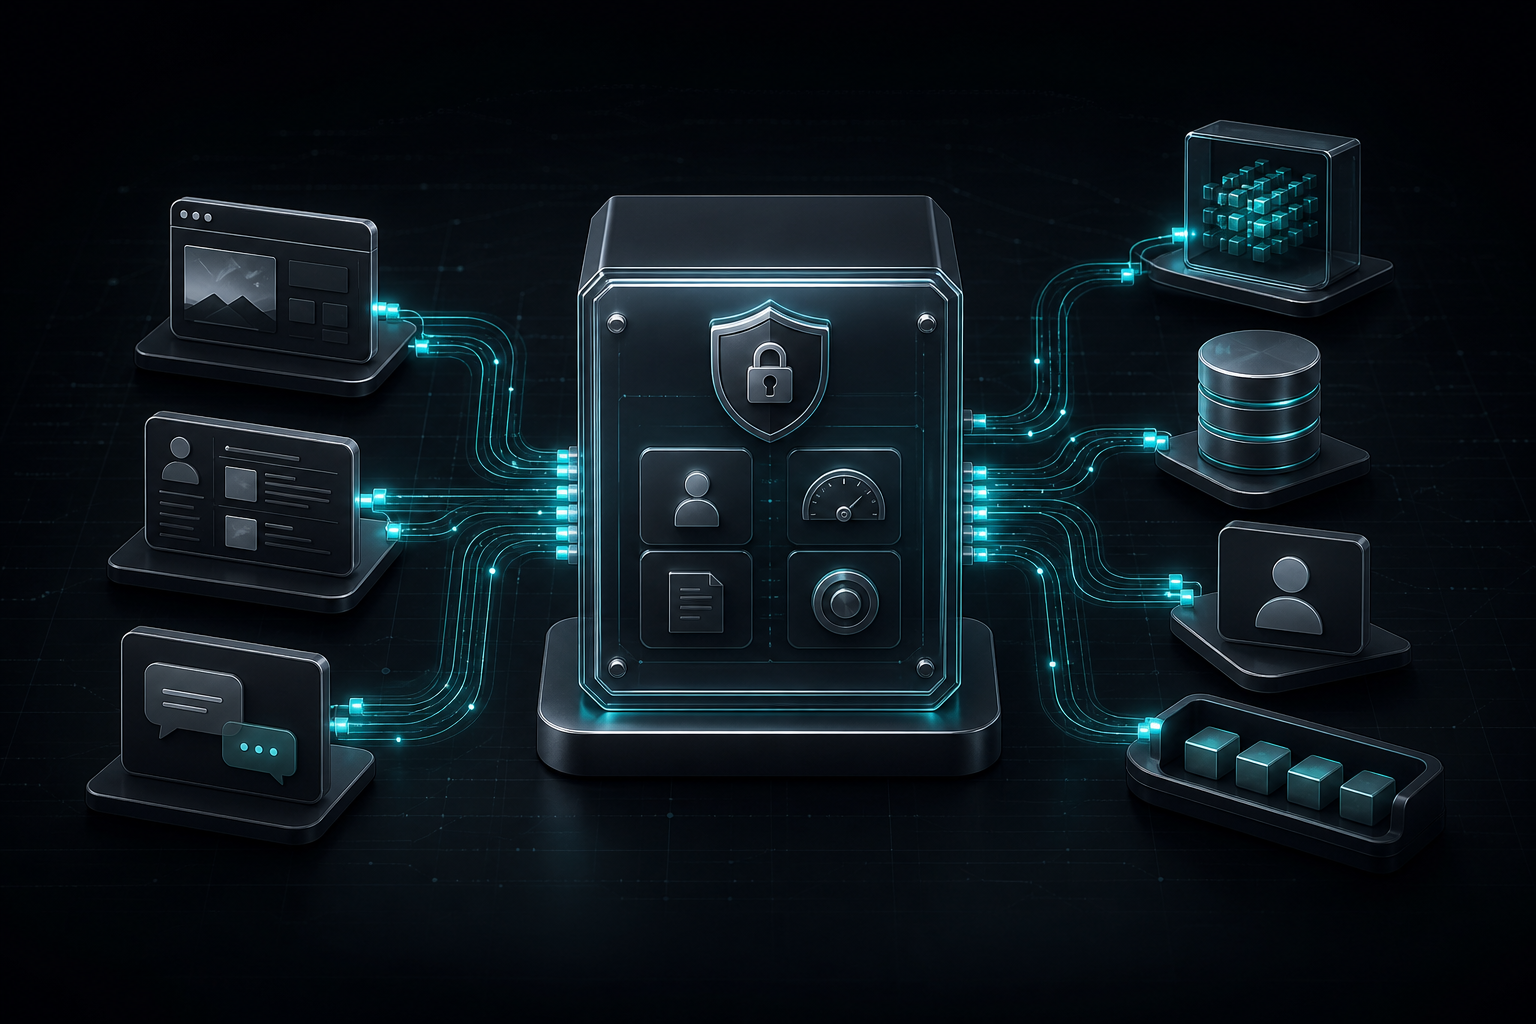
Backend становится управляемым шлюзом между пользователем, моделью и бизнес-системами. Через него можно заменить провайдера, ограничить запросы, маскировать чувствительные данные, применять разные модели для разных задач и отключить AI-функцию без остановки всего сайта.
Хранилище истории, векторный индекс и очередь задач нужны не всегда. Архитектуру следует собирать под конкретный сценарий, а не подключать максимальный набор технологий к простому генератору текста.
Как backend вызывает API модели
Сервер принимает запрос, идентифицирует пользователя, проверяет доступ и внутренние лимиты продукта. Затем он формирует набор сообщений, вызывает API выбранной модели и возвращает готовый либо потоковый ответ.
В запрос обычно входят:
- системная инструкция с правилами поведения;
- текущий запрос пользователя;
- нужная часть истории диалога;
- найденные фрагменты базы знаний;
- описание доступных функций;
- параметры генерации и внутренний trace ID.
Передавать всю переписку, каталог или архив документов при каждом обращении не нужно. Лишний контекст увеличивает задержку и стоимость, а также расширяет поверхность возможной утечки.
@app.post("/api/ai/message")
def ai_message(request, user):
    check_access(user)
    check_user_limit(user)
    context = find_relevant_context(request.text, user)

    result = llm.generate(
        system=SYSTEM_PROMPT,
        user=request.text,
        context=context,
    )

    return validate_output(result)
Это упрощённая схема. В production-коде дополнительно нужны таймауты, ограниченные повторы, проверка входных данных, бюджеты, маскирование чувствительных данных, логирование, обработка ошибок и fallback.
Streaming позволяет показывать ответ по мере генерации и улучшает воспринимаемую скорость. Саму работу модели он не ускоряет, поэтому длительные операции всё равно следует проектировать отдельно.
Prompt, история и контекст
System prompt задаёт роль, формат и общие правила ответа. User input содержит текущий запрос. Conversation history помогает поддерживать диалог, а retrieved context добавляет найденные сведения. Результаты функций передаются модели как tool output.
Prompt не заменяет бизнес-логику. Фразы вроде «не показывай финансовые документы другим отделам» недостаточно: доступ должен проверяться программно до того, как фрагменты попадут в контекст. То же относится к скидкам, платежам, изменению заказов и другим критическим операциям.
Историю обычно сокращают: оставляют последние сообщения, сохраняют структурированные факты или периодически формируют резюме. При этом нельзя без проверки превращать пользовательский текст в доверенную системную инструкцию.
Когда нужна база знаний и RAG
RAG нужен, если ответ должен опираться на документы компании: каталог, инструкции, договоры, регламенты, техническую документацию или внутренние справочники. Во многих таких сценариях модель не переобучают: нужные сведения находят и добавляют в контекст во время запроса.
- Документы очищаются и разбиваются на смысловые фрагменты.
- Для фрагментов создаются embeddings и поисковый индекс.
- По запросу выбираются релевантные части.
- Backend проверяет права пользователя на каждый найденный фрагмент.
- Разрешённый контекст передаётся модели для подготовки ответа.
RAG помогает отвечать по корпоративным материалам, но не исключает фактические ошибки. Требуются тесты retrieval, проверка атрибуции и сценарий для случая, когда надёжного ответа нет. Ссылки и идентификаторы источников следует прикреплять на backend из retrieval-метаданных, а не полагаться на то, что модель самостоятельно сформирует их без ошибок.
Цены, остатки, статусы заказов и другие быстро меняющиеся сведения лучше получать из API в момент запроса. Загруженная в индекс копия может устареть. Дополнительный разбор базы знаний и разрешённых действий есть в материале «AI-ассистент для бизнеса: что умеет и как работает» в разделе об AI-решениях.
В многопользовательской системе права исходного документа должны сохраняться у каждого индексированного фрагмента. Сначала применяется фильтр по организации, роли и доступу, затем выполняется поиск. Иначе качественный поиск может превратиться в канал утечки между отделами или клиентами.
Как дать нейросети доступ к функциям системы
Function calling позволяет модели предложить вызов заранее описанной функции и вернуть структурированные аргументы. Фактическое действие выполняет приложение — модель не должна подключаться к CRM или 1С напрямую.
«Запиши меня на пятницу» → модель предлагает check_slots → backend проверяет параметры и доступные слоты → модель уточняет время → пользователь подтверждает → backend вызывает create_booking → результат записывается в журнал
Через tools можно искать товар, проверять заказ, рассчитывать стоимость, создавать лид или формировать документ. Для каждой функции необходимы:
- allowlist разрешённых инструментов;
- строгая схема и серверная проверка аргументов;
- проверка пользователя, роли и tenant;
- минимально необходимые права интеграционного аккаунта;
- идемпотентность для защиты от повторного выполнения;
- подтверждение платежей, удаления и других необратимых действий;
- ограничение длины цепочки tool calls.
Аргументы от модели считаются недоверенным вводом. Если она предложила скидку 90%, изменила идентификатор клиента или передала лишнее поле, backend обязан отклонить запрос по тем же правилам, что применяются к обычному API.
Нагрузка, очереди и ограничения
У интеграции есть два слоя ограничений. Первый задаёт AI-провайдер: количество запросов, токенов и параллельных генераций. При превышении квоты API может вернуть ошибку 429. Второй слой устанавливает сам продукт: лимиты на пользователя, IP, организацию, endpoint, период и доступный бюджет.
Минимальный anti-abuse для публичного AI-сценария включает:
- rate limit по IP и авторизованному пользователю;
- дневную квоту запросов или токенов;
- ограничение длины prompt, ответа и файлов;
- лимит одновременных генераций;
- защиту от повторяющихся автоматических запросов;
- CAPTCHA или challenge при аномальной активности;
- аварийный kill switch.
Такая защита снижает риск не только перегрузки, но и denial-of-wallet — накрутки платных вызовов через публичный endpoint.
Интерактивный чат обычно работает синхронно или через streaming. Очереди применяются для обработки документов, массовой генерации, обновления embeddings, анализа карточек, формирования отчётов и публикации контента по расписанию. Для временных ошибок используют ограниченный retry с exponential backoff и jitter. Необработанные фоновые задачи можно отправлять в dead-letter queue для расследования и повторного запуска.
Из чего складывается стоимость интеграции ИИ
Стоимость разработки определяется не названием модели, а контуром решения. Базовый сценарий включает интерфейс, backend endpoint, подключение API, prompt и тестирование. Следующий уровень добавляет RAG, подготовку документов, индекс и права. Более сложные системы работают с несколькими источниками данных, выполняют действия, используют очереди, роли, админ-панель и мониторинг.
Эксплуатационные расходы рассчитываются отдельно:
Расходы = входные токены × тариф входа + выходные токены × тариф выхода + embeddings + инструменты провайдера + хранение индекса + серверы, очереди и мониторинг
Тарифы и состав оплачиваемых инструментов различаются у провайдеров и меняются, поэтому расчёт лучше строить на реальной статистике пилота: среднем контексте, длине ответа, числе пользователей и пиковых нагрузках.
Как контролировать бюджет
- использовать компактную модель для классификации и простых ответов;
- подключать более сильную модель только для сложных запросов;
- ограничивать историю, число найденных фрагментов и длину ответа;
- кэшировать безопасные повторяющиеся результаты;
- обрабатывать фоновые задачи пакетно, если провайдер поддерживает такой режим;
- установить дневные и месячные бюджеты;
- настроить алерты и circuit breaker при аномальном росте расходов.
Бюджет следует проверять до вызова модели, а не только отражать в отчёте после списания.
Безопасность AI-интеграции
Backend с закрытым основным ключом — важная часть защиты, но не вся система безопасности. Production-решение также должно учитывать prompt injection, загрузку вредоносных документов, утечки через логи, чрезмерные права инструментов и попытки накрутить расходы.
Обязательный минимум
- секреты хранятся вне репозитория и клиентского кода;
- для dev, staging и production используются разные ключи;
- ключи ротируются и отключаются при подозрении на утечку;
- каждый запрос проходит авторизацию и проверку прав;
- ввод, файлы, токены, параллельность и расходы ограничены;
- чувствительные данные удаляются или маскируются до отправки;
- tools работают с минимальными permissions;
- критические действия требуют независимой проверки и подтверждения;
- модели и prompts проходят regression-тесты перед обновлением.
Защита RAG
Индексировать следует только разрешённые источники. Загруженный файл нельзя автоматически считать безопасным: он может содержать инструкции, пытающиеся изменить поведение модели. Права доступа необходимо хранить на уровне chunk, а удаление исходного документа должно приводить к удалению его фрагментов из индекса.
Контент другого клиента или подразделения не должен попадать в выборку даже тогда, когда он лучше совпадает с запросом. Изоляция tenant применяется до формирования контекста.
Персональные и коммерческие данные
До запуска нужно определить, какие сведения отправляются провайдеру, где и сколько они обрабатываются, что попадает в логи и можно ли исключить персональные данные. Условия хранения и использования запросов зависят от конкретного поставщика, endpoint, настроек и договора. Универсальное обещание, что данные нигде не сохраняются, некорректно.
Логи, мониторинг и fallback
Без наблюдаемости сложно понять, почему ответы ухудшились, расходы выросли или CRM получила неверную команду. Для каждого запроса полезно сохранять trace ID, сценарий, модель и версию, длительность, токены, оценочную стоимость, код ответа, количество retry, ID найденных документов, вызванные функции и итог операции.
Полные prompts и ответы не следует записывать без необходимости. В них могут быть персональные данные и коммерческая информация. Нужны маскирование, ограниченный срок хранения и разграничение доступа к журналам.
Основные показатели production-системы:
- latency и error rate;
- число ошибок 429 и таймаутов;
- токены и стоимость по сценарию или tenant;
- ошибки tools и повторные операции;
- доля fallback и передачи человеку;
- качество на фиксированном тестовом наборе.
Fallback не ограничивается переключением на резервную модель. Это может быть повтор с задержкой, сохранение заявки без AI-обработки, очередь на повторный запуск, упрощённый сценарий, передача оператору или сообщение о временной недоступности. Если отказала проверка прав или безопасный поиск по документам, продолжать работу в менее защищённом режиме нельзя.
Практический пример: AI-консультант сайта с CRM
Посетитель задаёт вопрос об услуге. Backend проверяет ограничения по IP и сессии, обрабатывает ввод и запускает поиск по базе знаний. RAG возвращает разрешённые фрагменты, модель готовит ответ, а backend прикрепляет проверенные ссылки или идентификаторы источников из retrieval-метаданных.
Если запрос показывает коммерческое намерение, консультант собирает контактные данные. После подтверждения backend вызывает разрешённую функцию создания лида в CRM. Неуверенный, конфликтный или нестандартный вопрос передаётся менеджеру. Все этапы связываются одним trace ID.
Для MVP могут быть достаточны интерфейс, один backend endpoint, небольшой набор документов, лимиты и передача оператору. Очереди, расширенная аналитика, несколько моделей и сложные tools добавляются после проверки спроса и качества.
В портфолио WebSolux есть калькулятор технического обслуживания BMW: веб-сервис определяет работы по автомобилю, подбирает запчасти, формирует AI-рекомендации и редактируемую смету.
Другой формат — Content Bot: система собирает материалы, использует базу знаний, генерирует публикации, отправляет их на ручную модерацию и публикует по расписанию. Это пример асинхронного AI-конвейера с human-in-the-loop. Виртуальная примерка люксовых очков показывает, что AI-интеграция может работать с Computer Vision и пользовательским изображением, а не только с LLM.
Частые вопросы
Можно ли подключить ChatGPT к сайту?
Да, но технически сайт обычно подключается к API модели, а не к пользовательскому интерфейсу ChatGPT. Потребуются аккаунт API-платформы, серверная часть и отдельная настройка оплаты. Условия подписки на пользовательский продукт и оплаты API нужно проверять у провайдера.
Нужен ли backend?
Для основной логики production-интеграции обычно нужен backend: он защищает постоянный ключ, проверяет пользователей, управляет контекстом, применяет лимиты, выполняет RAG и контролирует функции. Прямое клиентское соединение допустимо только в тех сценариях, где провайдер официально поддерживает короткоживущие секреты, выдаваемые сервером.
Как защитить API-ключ?
Хранить основной ключ на сервере в переменных окружения или secret manager, не добавлять в Git и клиентский код, разделять ключи по окружениям, ограничивать права и регулярно ротировать. При подозрении на утечку ключ следует отключить.
Как ограничить расходы?
Установить лимиты запросов и токенов на пользователя, ограничить prompt и ответ, применять разные модели по сложности, кэшировать безопасные результаты и задавать дневные и месячные бюджеты. При аномальном росте затрат circuit breaker может временно остановить платные вызовы.
Нужно ли обучать модель на документах компании?
Не всегда. Для каталога, инструкций и базы знаний часто применяется RAG: система находит подходящие фрагменты и передаёт их модели во время запроса. Fine-tuning решает другие задачи и не заменяет доступ к актуальным данным.
Можно ли подключить ИИ к CRM или 1С?
Да, если система предоставляет API, webhooks или другой контролируемый способ обмена. Модель предлагает действие, а backend проверяет права, параметры и бизнес-правила перед фактическим вызовом.
Что требуется для оценки проекта
Надёжная интеграция ИИ строится вокруг backend, данных, ограничений и бизнес-процесса, а не вокруг выбора самой популярной модели. Для предварительной оценки достаточно описать сценарий, пользователей, источники данных, необходимые действия, ожидаемую нагрузку и требования к размещению информации.
WebSolux разрабатывает AI-инструменты и интеграции для сайтов, веб-сервисов и внутренних систем. В зависимости от задачи архитектура может включать RAG, подключение CRM, очереди и мониторинг. Посмотреть примеры можно в портфолио WebSolux, а определить состав MVP — на странице услуг и направлений разработки.
Источники
- OpenAI Realtime API — клиентские соединения и короткоживущие секреты.
- OWASP: Prompt Injection — риски недоверенного ввода и внешнего контента.
- OWASP RAG Security Cheat Sheet — защита retrieval, источников и доступа к данным.
- OWASP AI Agent Security Cheat Sheet — контроль инструментов, прав и действий.
- OWASP API Security: Lack of Resources & Rate Limiting — лимиты ресурсов и защита API.
Конкретные тарифы и квоты намеренно не зафиксированы: перед запуском их необходимо проверять в актуальной документации выбранного провайдера.